Code Mode e o custo de usar ferramentas
Code Mode muda como ferramentas são chamadas e quais dados chegam ao modelo. Revisei a documentação da Cloudflare, da Anthropic e da OpenAI e preprints sobre contexto e cache. Não rodei benchmark próprio.
Pense numa consulta paginada qualquer. Na chamada direta, o resultado de cada página volta ao modelo. No fluxo programático, o código usa o cursor, pede as páginas seguintes e devolve ao modelo só um recorte. O exemplo é conceitual. A Cloudflare descreve a paginação como uma das operações que o código pode coordenar.
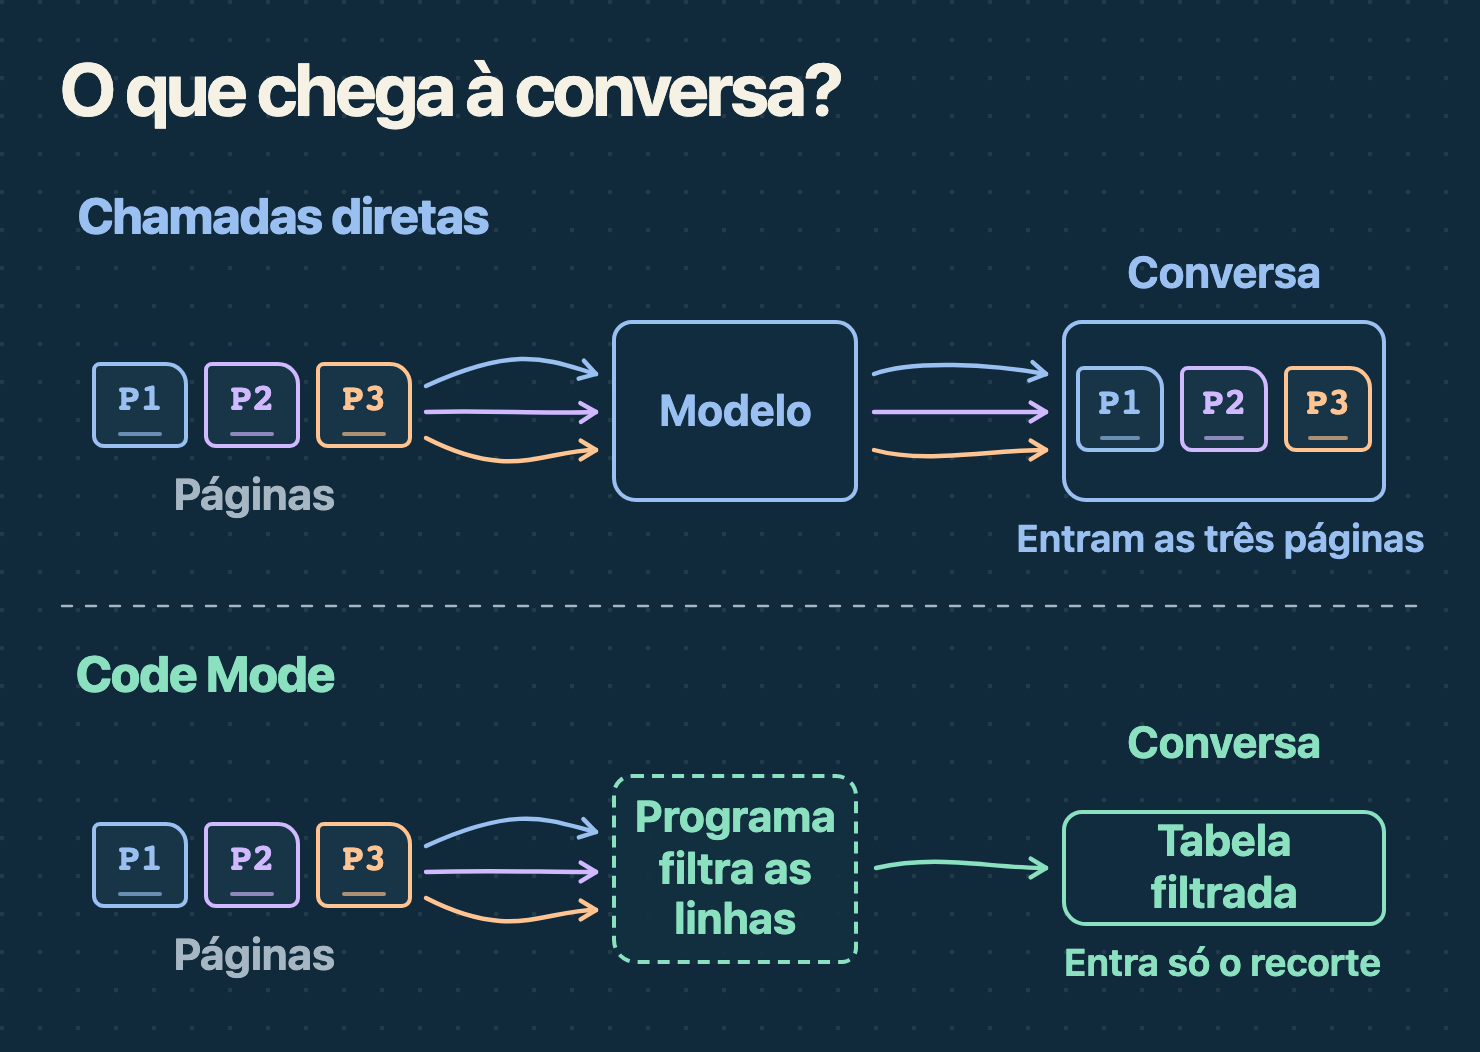
O fluxo por código pode poupar chamadas ao modelo, mas não elimina as requisições externas necessárias para obter os dados: as páginas continuam sendo pedidas. A diferença está em quais resultados intermediários chegam à janela de contexto.
O mecanismo
O artigo da Cloudflare sobre Code Mode compara dois jeitos de encadear ferramentas. No primeiro, as respostas voltam ao modelo. No segundo, o código passa a saída de uma chamada direto para a outra. A implementação descrita convertia as ferramentas MCP em uma API TypeScript e dava ao modelo uma ferramenta de execução. O código rodava num isolado, e o SDK encaminhava as chamadas aos servidores MCP. Nesse protótipo, a API TypeScript inteira entrava no contexto.
A publicação da Anthropic sobre execução de código com MCP separa os tokens das definições de ferramentas dos tokens das respostas intermediárias. Ela mostra três coisas: a descoberta seletiva de ferramentas, em que entram só as definições necessárias para a tarefa; a filtragem de linhas antes de o resultado voltar ao modelo; e laços de controle. O artigo não detalha um recorte idêntico ao da contagem de interfaces da Cloudflare, então os números dos dois não são comparáveis diretamente.
A contagem do catálogo na Cloudflare
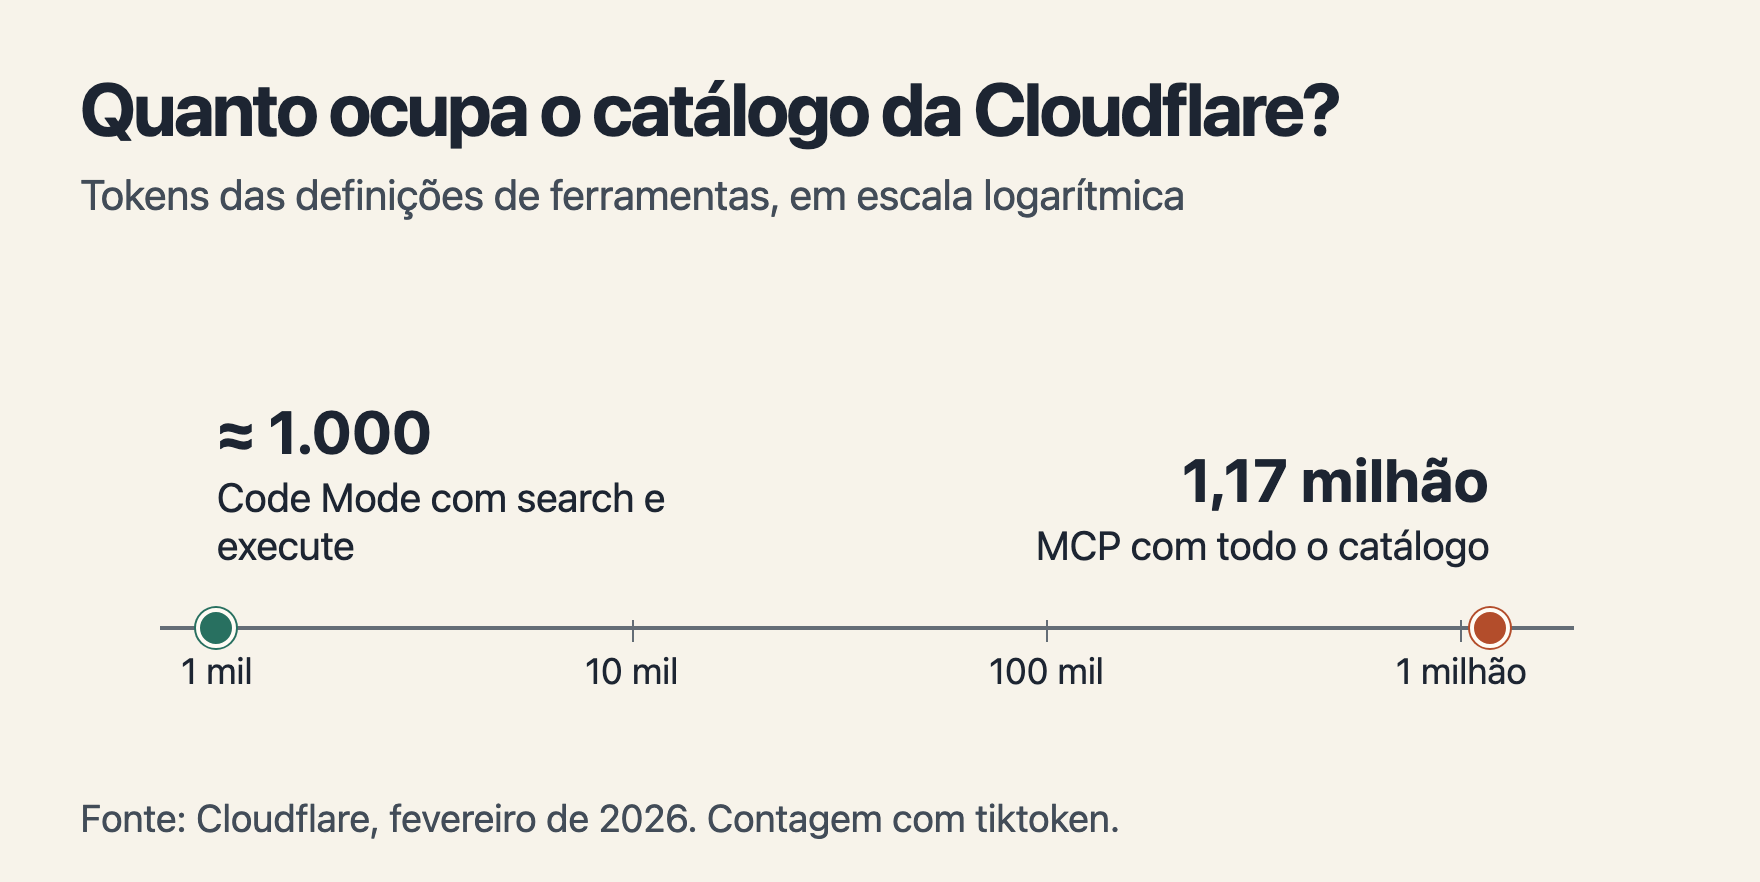
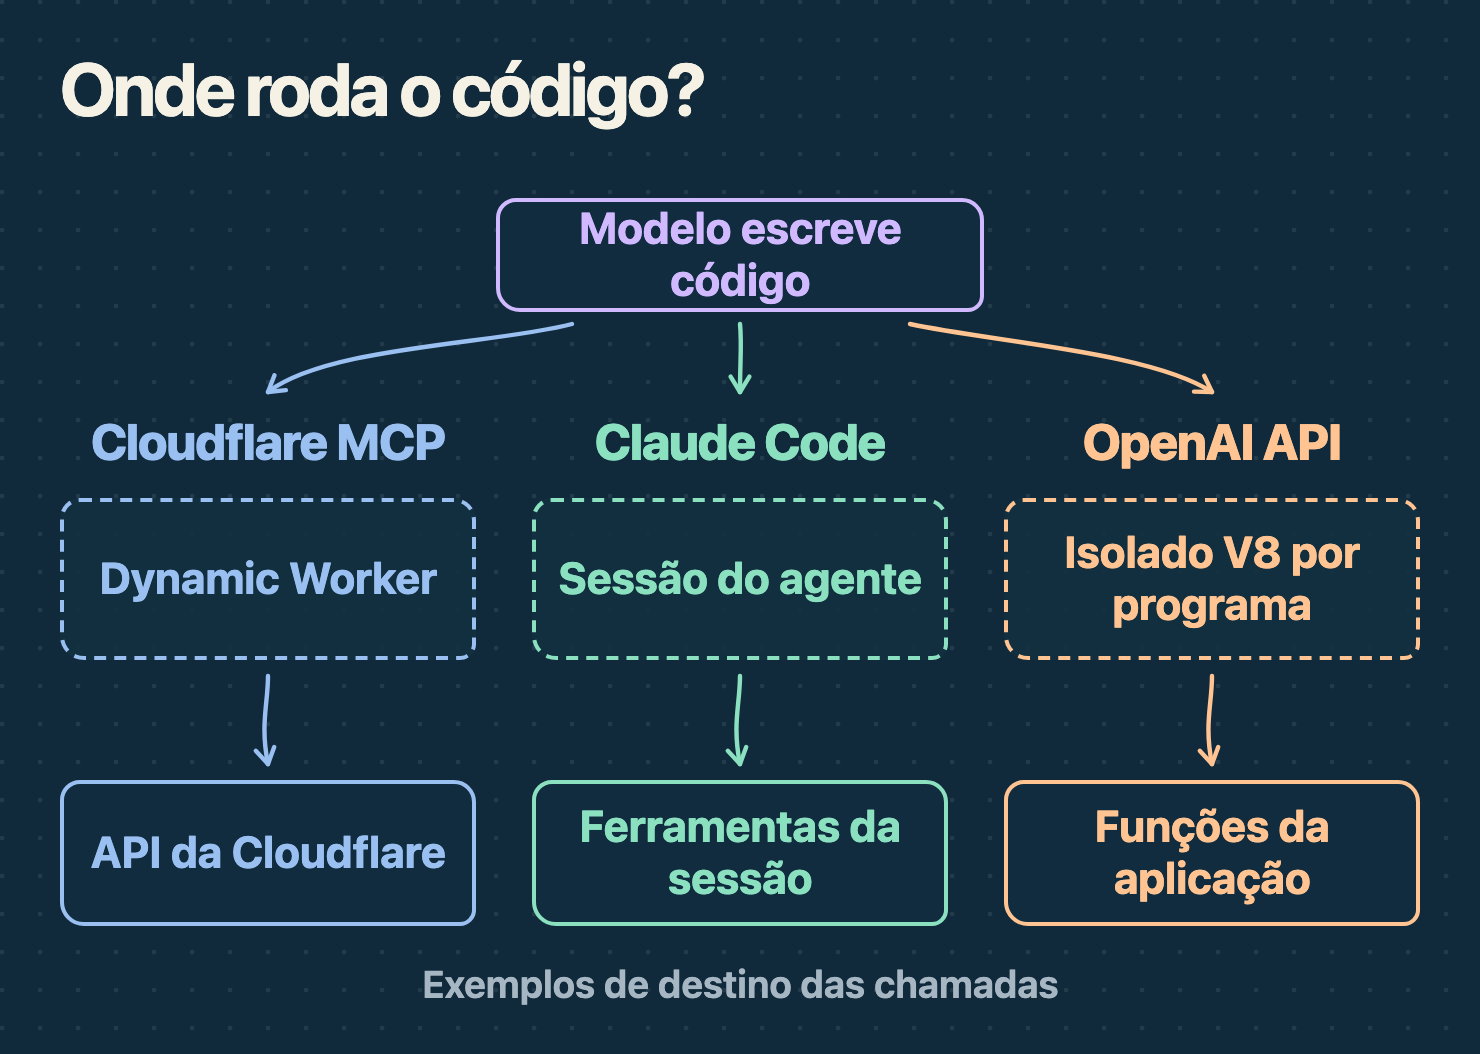
No artigo da Cloudflare que descreve a API em 1.000 tokens, o servidor MCP da API Cloudflare tem duas ferramentas, ambas rodando em Dynamic Workers. A search executa código sobre uma representação da especificação OpenAPI. A execute compõe as chamadas à API, inclusive para paginar. Na especificação completa da API da Cloudflare, são mais de 2.500 endpoints. As duas ferramentas somam cerca de 1.000 tokens, contra 1,17 milhão de tokens de um catálogo equivalente com todas as definições, medidos com tiktoken. A diferença no tamanho estimado das interfaces é de aproximadamente 99,9%. Essa conta mede só os tokens das definições de ferramentas. Ela não mede preço, tempo, número de chamadas nem taxa de acerto.
Claude Code e Programmatic Tool Calling da OpenAI
No Claude Code, o Code Mode é experimental e vem desligado por padrão. Ele está disponível a partir do Claude Code nativo 2.1.323, em terminal interativo, desde que se cumpram os requisitos do guia. O Claude escreve JavaScript com chamadas de ferramenta, e o Claude Code executa esse código na própria sessão, inclusive com ferramentas como Bash, Read e Edit. O atalho Ctrl+O abre o visualizador da transcrição, onde dá para expandir as linhas Code e ler o JavaScript.
Cada chamada feita no Code Mode do Claude Code passa pelas regras de negação e de confirmação e pelos hooks PreToolUse. A busca de ferramentas MCP no Claude Code é outro recurso: ela carrega as descrições sob demanda nas configurações compatíveis.
No Programmatic Tool Calling da OpenAI, cada programa JavaScript roda num isolado V8 novo, sem estado JavaScript que persista entre programas e sem rede direta. O acesso a sistemas externos passa pelas ferramentas disponibilizadas. Na Responses API, a aplicação decide quais ferramentas elegíveis podem ser chamadas diretamente, pelo código ou dos dois jeitos, e continua executando as funções que são dela. Para MCP, a política require_approval pode pausar o programa. A documentação indica o recurso para resultados volumosos, agregação e chamadas dependentes com fluxo de dados previsível. Para etapas que dependem de aprovação, recomenda a ação direta como padrão.
O Tool Search da OpenAI carrega as definições das ferramentas declaradas como adiadas. Na Responses API, é uma ferramenta de nível superior. Uma ferramenta encontrada por ele pode ser chamada por um programa posterior, se permitir chamadas programáticas. Nas duas plataformas, então, a busca sob demanda atua sobre as definições, e a execução de código pode filtrar os resultados dentro do ambiente de execução.
O que os preprints dizem sobre cache e contexto
O preprint Context Has a Price, de Yang et al., publicado em 17/11/2026, reúne mais de 20 mil execuções de modelos abertos no SWE-bench Verified, no SWE-bench e no Loc-Bench. Os autores estimaram o custo a partir dos tokens registrados, com preços relativos para entrada nova, entrada em cache e saída. Sem desconto para a entrada em cache, remover observações antigas reduziu o custo estimado entre 19% e 36%. Com a entrada em cache custando um décimo da entrada nova, a mesma remoção elevou o custo estimado entre 38% e 116%. São custos estimados sob tarifas relativas, não uma fatura de API medida, e se referem à comparação entre os braços de um estudo de edição de contexto, não a um benchmark de Code Mode. Os autores também viram que prompts menores podem mudar o número de passos do agente.
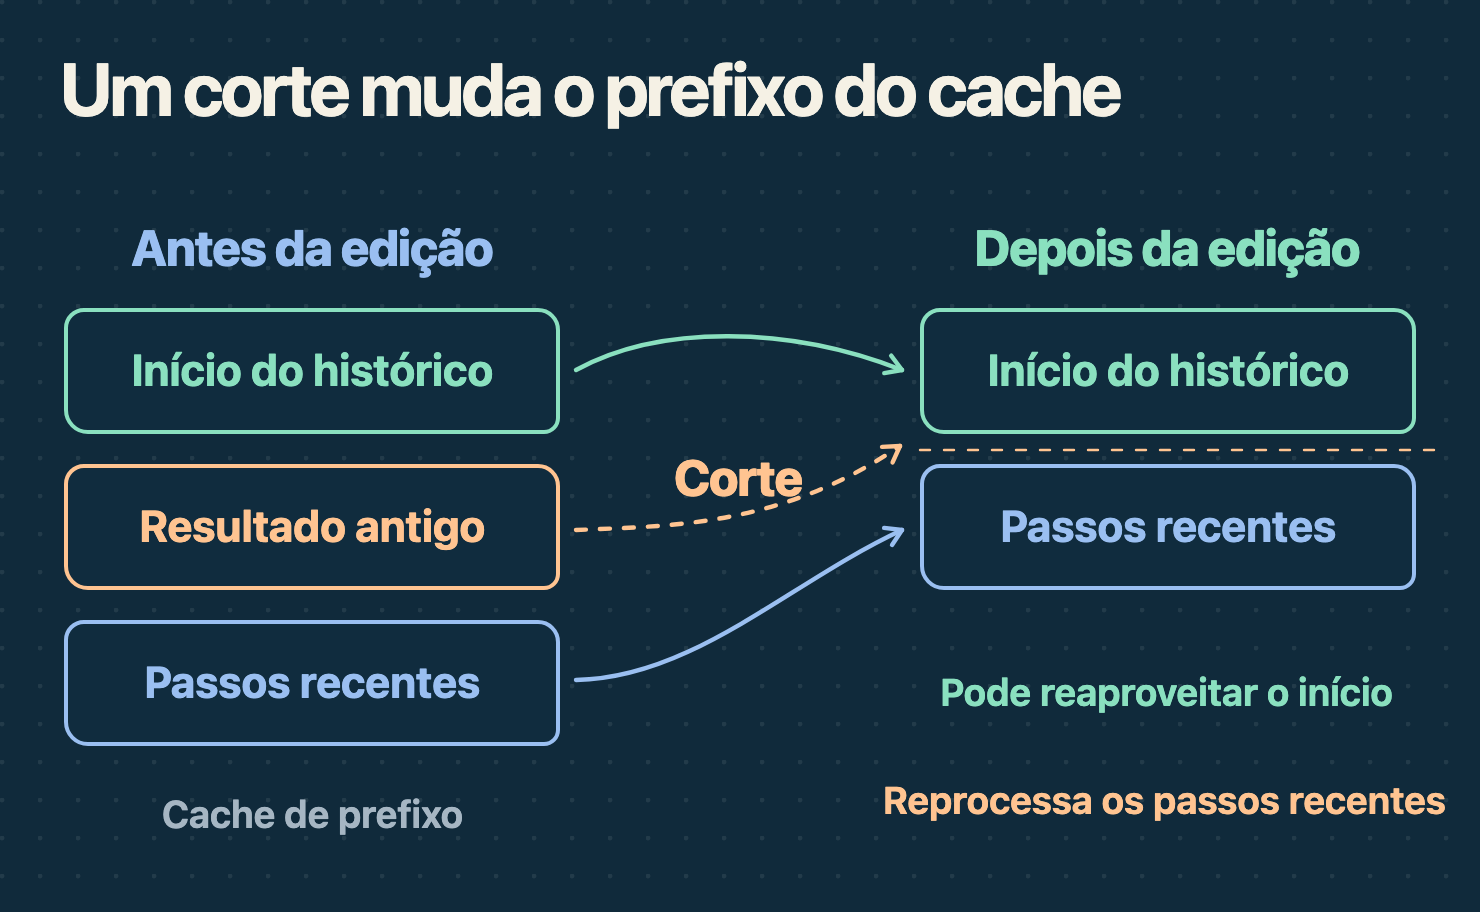
A documentação da Anthropic sobre edição de contexto diz que, na API do Claude, remover resultados antigos de ferramentas invalida os prefixos em cache e gera o custo de uma nova escrita. O preprint aproxima o reaproveitamento de cache sem reproduzir as cobranças de escrita de cada provedor.
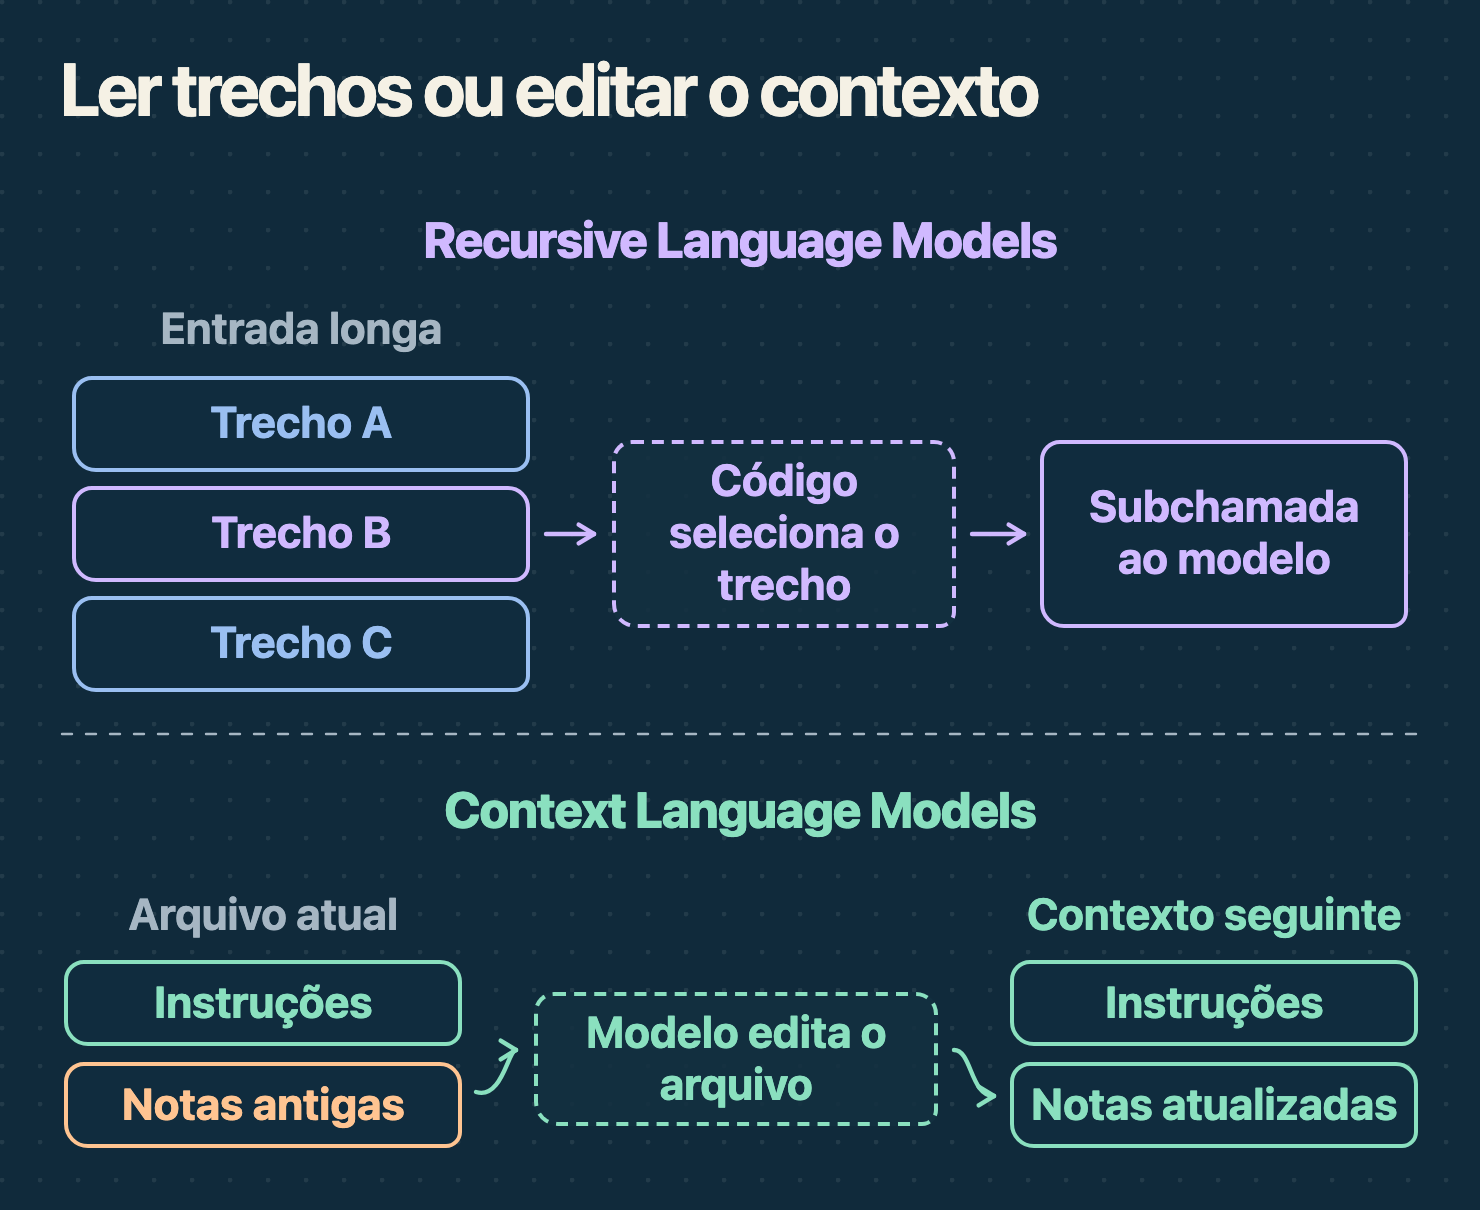
Dois preprints tratam de coisas diferentes e não devem ser confundidos. Em Recursive Language Models, de Zhang, Kraska e Khattab, publicado inicialmente em dezembro de 2025, a entrada longa fica guardada num ambiente externo, e o modelo opera sobre ela por código: lê trechos, decompõe o problema e inicia subchamadas de modelo. Em Context Language Models, de Shao et al., publicado em 29/09/2026, o próprio modelo administra seu contexto como um arquivo editável. A seção 5.3 desse trabalho avalia o Suffix Cache Reuse. Os autores relatam 35% menos computação do servidor em relação ao SGLang padrão, com desempenho equivalente no cenário testado. O número é de computação do servidor e vale para o hardware e a configuração daquela avaliação.
Como medir custo e correção na mesma tarefa
Esta revisão foi documental. Li documentação oficial, artigos técnicos de fornecedores e preprints e comparei os denominadores, os preços e as linhas de base que cada um publica. Consultei as fontes em 19 de novembro de 2026. Não executei benchmark próprio.
Para um teste futuro, o guia da OpenAI orienta partir das chamadas diretas e comparar os dois fluxos em tarefas representativas. A avaliação cobre correção, completude, evidência, latência e custo. Uma consulta fictícia com uma tabela de referência permite definir de antemão quais registros e valores são esperados. Nos dois fluxos, o modelo, as ferramentas e os dados precisam ser comparáveis.
A contagem de catálogo, o custo de uma tarefa e o efeito do cache têm unidades e linhas de base próprias. A contagem da Cloudflare mede tokens de definições. O estudo de edição de contexto mostra que o preço da entrada em cache pode inverter o sinal da economia estimada.
Rascunho de agente a partir das fontes listadas; revisado e aprovado por Lucas Fuad