562 specs depois: o que mudou quando o pronto do agente passou a ter portão
Desde agosto, toda feature feita por agente aqui passa por uma spec do Specsfy. Medi 562 specs, os meus pedidos, o custo em tokens e a entrega no GitHub. Eu decido no começo, o agente encadeia fases sozinho, e cerca de metade do custo vai para definir e mudar a spec.
Em 29 de outubro, uma auditoria achou testes sem RED válido em cinco specs do Fuad Next. A maioria tinha sido escrita depois do código, e o agente tinha marcado essas tarefas como feitas. A regra do método é a contrária: o teste vem antes, falha pelo motivo certo (o RED) e só então o código entra.
Respondi a quatro perguntas numeradas e concedi exceção só para as tarefas apontadas. Os testes ficaram como regressão, sem fingir um RED que não aconteceu. A auditoria só foi possível porque cada tarefa, cada critério de aceite e cada teste estão amarrados num arquivo só. É isso que o Specsfy faz no meu fluxo desde agosto, e eu medi o que mudou com ele.
De onde a gente vinha
Até agosto, o fluxo era o Superpowers: skills de processo para agentes de código, com brainstorming, plano escrito, execução por subagentes e verificação antes de concluir. Em volta dele, a gente criou práticas próprias conforme os problemas apareciam: um handoff no fim de cada sessão para a próxima continuar de onde parou, decisões em arquivos numerados, aceite do app real dirigido pelo próprio agente e troca de mensagens entre o Mac e o notebook Windows.
Funcionava, mas o plano, as decisões, os testes e a prova de que algo estava pronto ficavam em lugares diferentes. No fim, quem dizia que uma tarefa estava pronta era o agente.
Um caminho só, com portões
O Specsfy é um framework de desenvolvimento orientado por especificação, criado por Luiz Eduardo Fonseca, da Promovaweb, que cita o GitHub Spec Kit como uma das inspirações. Não é nosso, mas a gente já contribuiu com ele. Desde 20 de agosto, cada feature segue este caminho:
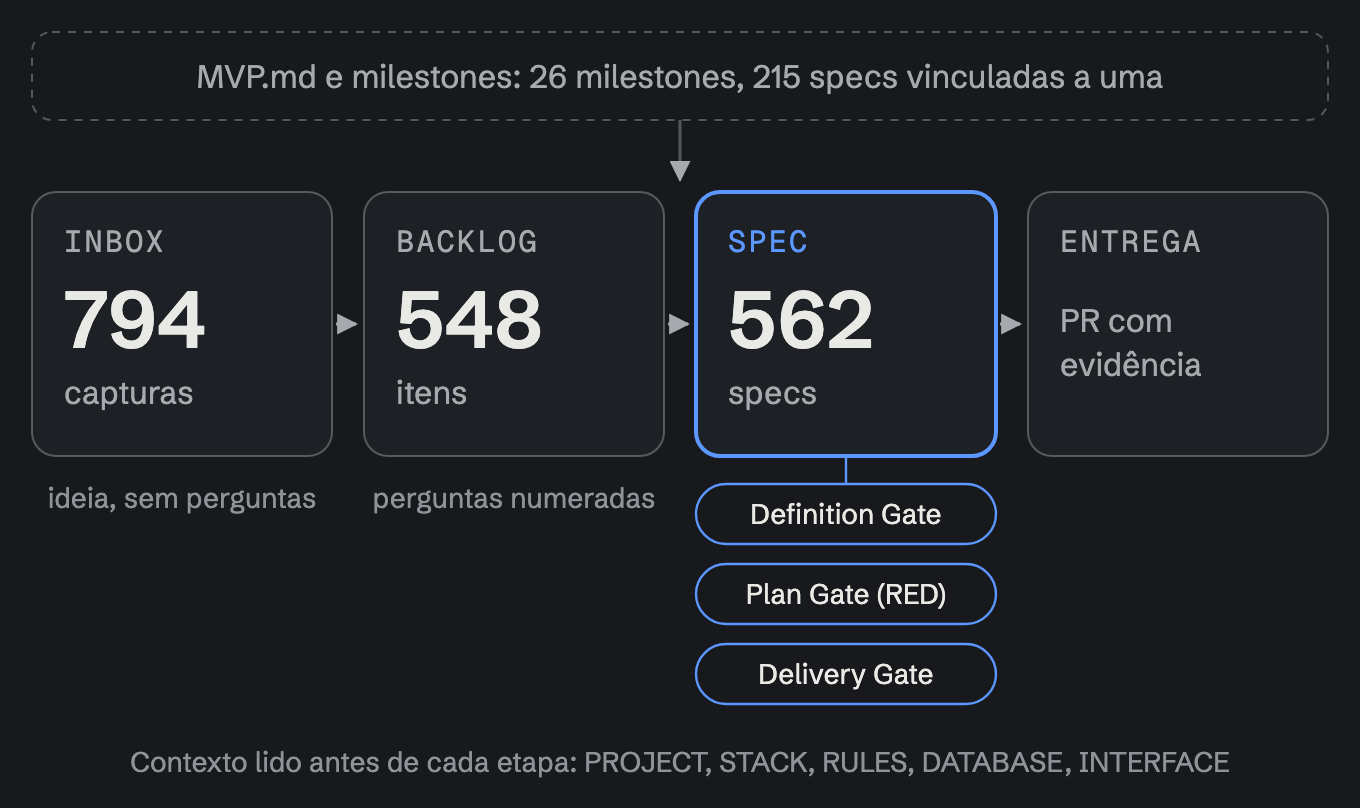
- O inbox guarda uma ideia na hora, sem perguntas, com o texto original.
- O backlog transforma a captura em decisão, por perguntas numeradas, e não autoriza implementar nada.
- A spec é um arquivo só, com problema, requisitos, critérios de aceite, tarefas, testes e evidência. Plano ou lista de tarefas em arquivo separado é proibido.
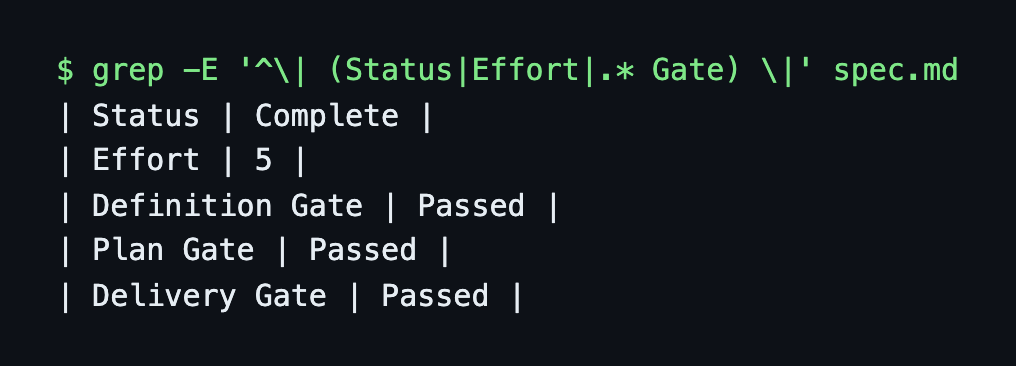
- A spec passa por três portões: definir (Definition Gate), provar com os testes falhando antes do código (Plan Gate) e entregar com evidência (Delivery Gate). Mudar o comportamento depois reabre os três.
Num produto novo, o fluxo começa um passo antes, com uma entrevista que define o MVP e o divide em milestones: estados do produto que dá para demonstrar, cada um com uma condição de saída. O agente pode implementar as specs de uma milestone uma atrás da outra, mas a milestone só fecha quando eu confirmo que a condição foi demonstrada.
A captura no meio do trabalho
O uso de que mais gosto é o inbox no meio de outra coisa. Estou numa sessão implementando uma spec, aparece um problema que não é dela, e eu peço ao agente para analisar o caso e ler uma fonte que eu indico. No fim, ele registra um inbox. A captura sai com o contexto daquele momento, eu não paro o que estava fazendo, e na sessão seguinte o item já começa com o caso explicado. Cerca de um em cada quatro acionamentos do inbox veio no meio de outra etapa do fluxo, na mesma sessão.
O tamanho do uso
| Em 7 de novembro, nos nove repositórios | Total |
|---|---|
| Specs | 562, das quais 463 concluídas |
| Critérios de aceite | 11.417 |
| Tarefas | 18.387 |
| Marcadores ligando um teste ao critério que ele cobre | 20.096 |
As specs não são pequenas. No Fuad Next, a spec mediana tem 16 critérios de aceite e Effort 6. O Effort é a nota de dificuldade, de 1 a 10, registrada em cada spec, e não tem a ver com o esforço de raciocínio do modelo, que aparece mais adiante.
Onde eu entro
A minha parte se concentra no começo. As perguntas chegam numeradas, uma por vez, com as opções prontas, e muitas vezes eu respondo só com um número. A pergunta abaixo é um exemplo: o Specsfy manda usar Pest em projeto PHP, o worker desse projeto é Node, e o agente trouxe três jeitos de encaixar uma coisa na outra.
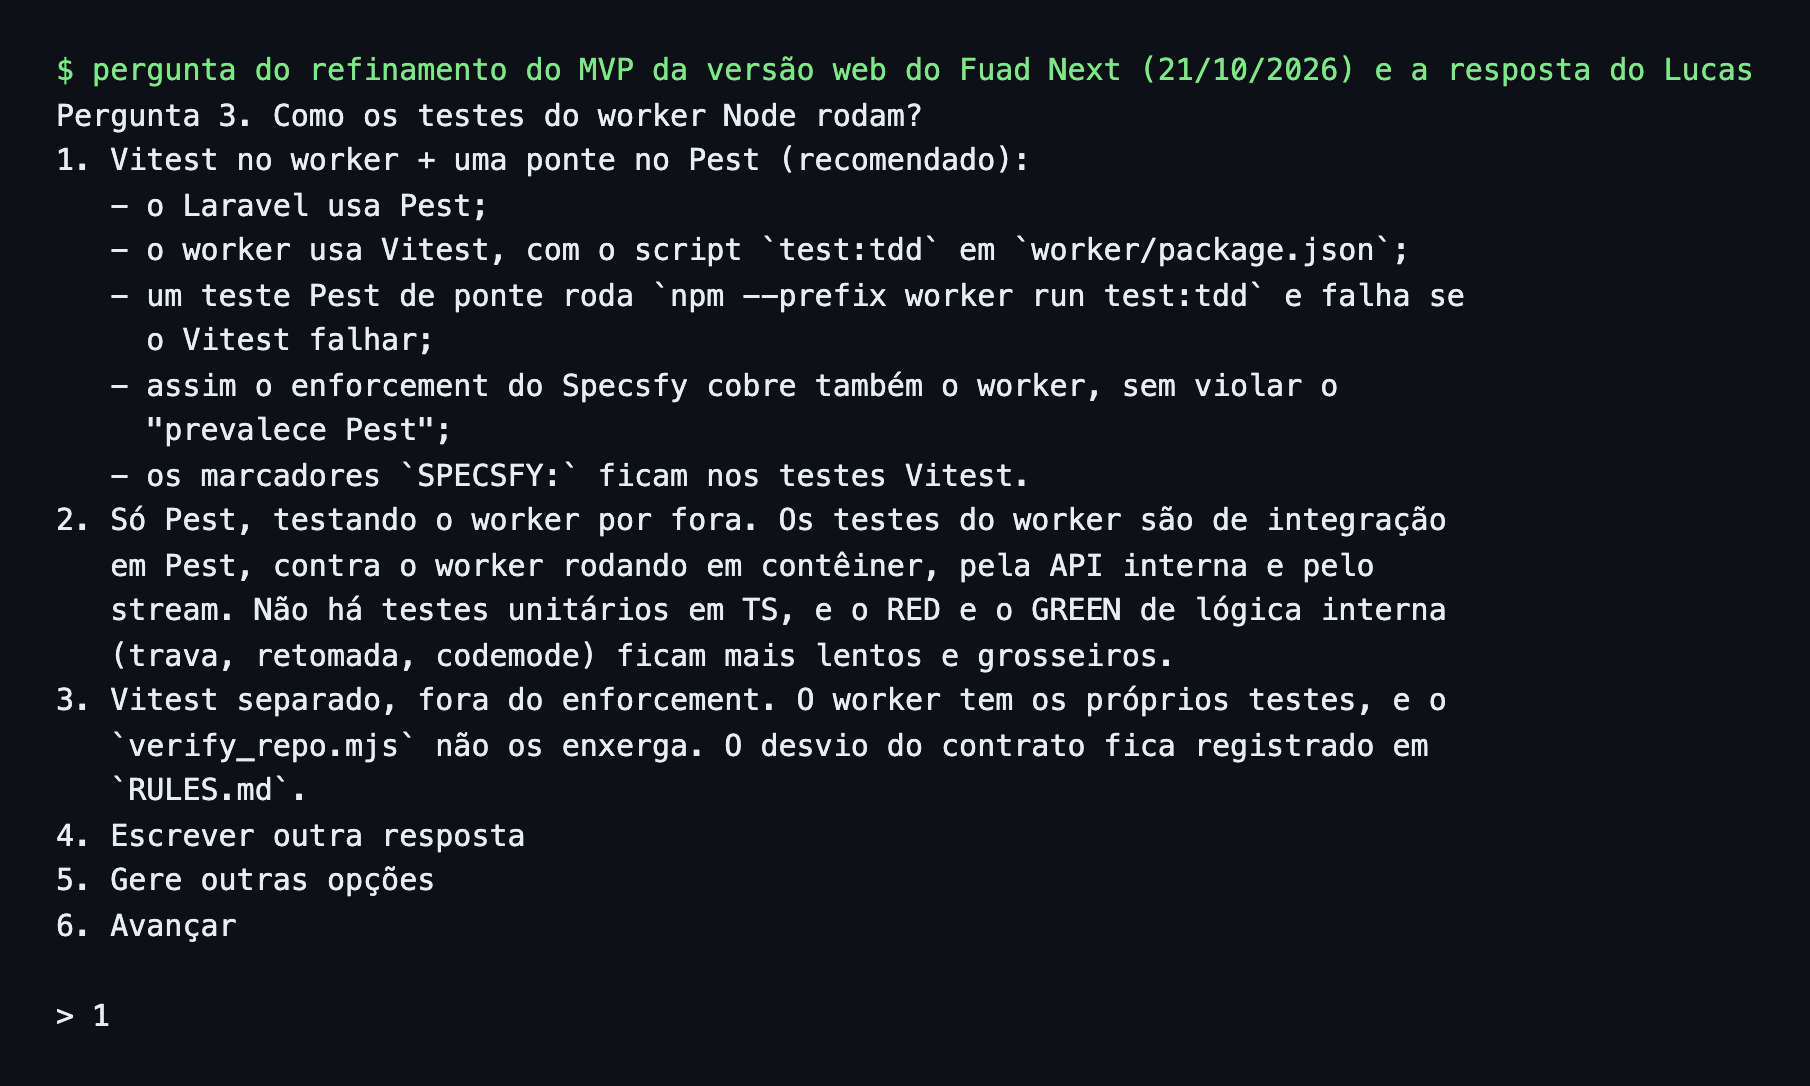
Para ver se isso acontece de fato, contei os meus pedidos por fase do fluxo e quantos deles foram só o número de uma opção. A primeira coluna é essa parte; a segunda, quantos pedidos caíram em cada fase.
| Braço | Só o número da opção (%) | Pedidos |
|---|---|---|
| Captura e refinamento (inbox, backlog, entrevistas) | 49,6 | 1516 |
| Setup | 28,0 | 322 |
| Da criação da spec à implementação | 22,2 | 1246 |
| Outras skills (documentação, especialistas) | 19,5 | 512 |
| Mudança tardia | 17,6 | 255 |
| Trabalho de spec sem acionar skill | 17,2 | 937 |
| Antes da primeira skill da sessão | 6,3 | 824 |
| Sessões sem relação com spec | 3,4 | 591 |
Fonte: Transcripts locais do Claude Code: 6.203 pedidos humanos em 680 sessõescommit 17d0066MetodologiaBaixar JSONBaixar CSV
Na captura e no refinamento, metade dos meus pedidos foi só um número. Nas sessões sem relação com spec, foram 3%. A diferença vem do formato: quando o agente já chega com as opções pensadas, decidir vira escolher. Da criação da spec em diante, a parte cai para cerca de 20%, porque ali eu confirmo, respondo e corrijo o rumo com frases. E uma parte do trabalho nem passa por mim: das 158 sessões que trabalharam numa spec sem acionar skill, 123 foram abertas por outra sessão, a que coordena as frentes, e 79 não têm nenhum pedido meu.
Depois de um pedido, o agente vai longe. Em 117 pedidos, ele passou por três ou mais skills do fluxo sem eu falar nada no meio, e a mediana foi de 45 minutos de trabalho. O Diário, o pipeline que gera os rascunhos deste site, fechou 15 specs em pouco mais de um dia, do primeiro inbox ao último aceite.
O que mudou na entrega
Encadear fases só vale se a entrega sair melhor, e eu queria saber se saiu. No Fuad Next, comparei pelo git e pelo GitHub os 83 dias antes da troca com os 80 dias depois, com quatro medidas:
- PRs mesclados por dia, para ver a vazão;
- PRs com achado da revisão do Codex, para ver o que passou a ser pego antes do merge;
- falha do Typecheck no CI, o único workflow que existe nas duas épocas;
- retrabalho, os PRs que receberam, em até 7 dias, uma correção num arquivo que eles mesmos criaram, o sinal mais próximo de defeito que escapou.
Junto com o Specsfy veio uma regra nossa: cada spec vira um PR numa worktree própria, com revisão do Codex antes do merge. A tabela mede esse pacote, não o método sozinho.
| Braço | PRs mesclados por dia | PRs com achado da revisão do Codex (%) | Falha do Typecheck no CI (%) | PRs com correção em arquivo criado por eles em 7 dias (%) |
|---|---|---|---|---|
| Depois (Specsfy) | 8,2 | 55,0 | 21,8 | 40,2 |
| Antes (Superpowers) | 2,1 | 0,0 | 60,0 | 36,5 |
Fonte: Git e GitHub do Fuad Next: 175 PRs mesclados antes e 655 depoiscommit 17d0066MetodologiaBaixar JSONBaixar CSV
Antes, quase tudo ia direto para a main. Depois, quase tudo passou por PR, e os PRs mesclados foram de 2,1 para 8,2 por dia, com o mesmo tamanho mediano, cerca de 840 linhas. Em 55% deles, a revisão do Codex achou alguma coisa antes do merge. O Typecheck caiu de 60% para 22% de execuções com falha, mas o antes tem só 45 execuções.
O retrabalho não mudou: 37% dos PRs antes e 40% depois. A revisão pega coisa antes do merge, mas não vi menos correção depois dele. A minha leitura é que mais PRs seguidos mexem nos mesmos arquivos centrais logo depois uns dos outros, e a medida não separa a correção de um defeito do ajuste da spec seguinte. Por pedido, a diferença também é pequena: foram 19,3 pedidos meus por plano do Superpowers antes e 16,8 por spec concluída depois, com documentos de entrega cerca de 50% maiores. O ganho que dá para afirmar é de vazão e de revisão, não de menos defeito.
Quanto o agente anda sozinho
Um pedido em que o agente trabalha mais de meia hora sem mim é um pedido em que eu posso fazer outra coisa. Por isso medi, mês a mês, a parte dos meus pedidos que passou de 30 minutos de trabalho do agente antes do pedido seguinte. No Codex, contei só as sessões que eu abri e digitei: as revisões que um agente pedia ao outro e as automações ficaram fora. Passe o mouse ou foque um ponto para ver o mês, o valor e quantos pedidos entraram na conta.
Pedidos com mais de 30 min (%)
Mês, 2026
* ago: Codex mistura dias antes e depois de 20/08; Claude Code a partir de 21/08
* nov de 1 a 7
Ver os números em tabela
| Mês | Codex | Claude Code |
|---|---|---|
| mai de 2026 | 9,3 | — |
| jun de 2026 | 2,1 | — |
| jul de 2026 | 13,1 | — |
| ago de 2026* | 7,3 | 11,1 |
| set de 2026 | 9,9 | 7,9 |
| out de 2026 | 12,3 | 11,3 |
| nov de 2026* | — | 18,2 |
Fonte: Transcripts locais: Claude Code (todas as sessões) e Codex (sessões interativas digitadas)commit 17d0066MetodologiaBaixar JSONBaixar CSV
A curva não mostra um salto na entrada do Specsfy. O Codex já chegava a 13% em julho, antes dele, e de setembro a outubro as duas curvas ficaram entre 8% e 12%. O salto veio em novembro, no Claude Code: 18% dos pedidos passaram de meia hora, e um em cada dez passou de 66 minutos. Foi quando eu passei a coordenar várias frentes ao mesmo tempo, cada uma numa sessão. Eu leio isso como a evolução do fluxo inteiro: modelo, agente, método e o jeito de trabalhar mudaram juntos, todo mês, e não tenho como separar a parte de cada um.
Claude Code contra Codex
Entre agosto e outubro, eu usei os dois agentes com o Specsfy. Para comparar sem misturar épocas, peguei o mesmo mês e quatro sinais de como o agente trabalhou:
- laço, o mesmo comando repetido três vezes em dez chamadas, o sinal mais direto de agente travado;
- chamada com erro, o comando que terminou com erro ou edição recusada;
- teste que falhou, que inclui o RED, o teste que o TDD manda escrever falhando antes do código;
- minutos por pedido, quanto ele trabalhou sozinho, na mediana.
| Braço | Laços a cada 100 chamadas | Chamadas com erro, a cada 100 | Execuções de teste que falharam (%) | Minutos por pedido (mediana) |
|---|---|---|---|---|
| Agosto · Claude Code (301 pedidos) | 0,0 | 1,8 | 34,2 | 4,1 |
| Setembro · Claude Code (442 pedidos) | 0,0 | 2,1 | 35,5 | 0,8 |
| Outubro · Claude Code (3.074 pedidos) | 0,1 | 2,0 | 30,9 | 1,4 |
| Agosto · Codex (382 pedidos) | 0,5 | 8,7 | 40,9 | 2,0 |
| Outubro · Codex (121 pedidos) | 0,6 | 7,1 | 22,3 | 3,1 |
| Setembro · Codex (1.024 pedidos) | 0,9 | 10,2 | 30,9 | 2,6 |
Fonte: Transcripts locais: sessões do Claude Code que acionaram skill do Specsfy e sessões interativas do Codex que leram skill do Specsfycommit 17d0066MetodologiaBaixar JSONBaixar CSV
Nos dois sinais de agente patinando, o Claude Code ficou abaixo em todos os meses: no máximo 0,1 laço a cada 100 chamadas, contra 0,5 a 0,9 no Codex, e de 1,8 a 2,1 chamadas com erro, contra 7,1 a 10,2. Parte da diferença de erros é de unidade: no Codex, uma chamada pode rodar vários comandos e conta como erro se qualquer um falhar. Nos testes que falharam, não há vencedor: a ordem se inverteu de um mês para outro, e o número carrega o RED que o próprio método pede.
Por spec, o Claude Code precisou de menos pedidos meus. Nas specs de Effort 7-8, foram 9 na mediana com ele e 18 com o Codex, que teve só 16 specs nessa faixa. Em troca, gastou mais tokens, de 1,3 a 1,9 vez conforme o recorte, e os dois agentes contam tokens de forma diferente. Os modelos eram outros dos dois lados, e eu escolhia o agente conforme a tarefa, então isto compara o fluxo de cada um no meu uso, não os agentes num teste controlado.
Modelos e máquinas no Codex
Dentro do Codex, eu troquei de modelo e de máquina ao longo dos meses, do notebook Windows para o Mac. Queria saber se alguma dessas trocas explica a diferença. O gráfico cruza duas medidas: no eixo vertical, a parte das execuções de teste que falharam; no horizontal, a parte dos pedidos que eu interrompi no meio, o sinal mais direto de que precisei intervir. Quanto mais para baixo e para a esquerda, menos atrito. Cada ponto é um modelo numa máquina e numa época: passe o mouse ou foque um ponto para ver os números.
Pedidos interrompidos (%)
Ver os números em tabela
| Braço | Execuções de teste que falharam (%) | Pedidos interrompidos (%) | Fronteira |
|---|---|---|---|
| gpt-5.6-sol, Windows, antes do Specsfy (jul–ago) | 41,9 | 7,9 | fora da fronteira |
| gpt-5.6-sol, Mac, depois do Specsfy (ago–set) | 40,4 | 2,0 | fora da fronteira |
| gpt-6-astra, Mac, depois do Specsfy (set) | 27,0 | 1,1 | na fronteira |
| gpt-5.5, Windows, antes do Specsfy (jun–jul) | 38,3 | 6,0 | fora da fronteira |
| gpt-6.1-sol, Mac, depois do Specsfy (set–nov) | 23,1 | 4,2 | na fronteira |
Fonte: Transcripts locais do Codex: sessões interativas com pedido humano, células com 100 pedidos ou maiscommit 17d0066MetodologiaBaixar JSONBaixar CSV
O caso mais claro é o gpt-5.6-sol, o único modelo que aparece dos dois lados da troca. No Windows, antes do Specsfy, eu interrompi 7,9% dos pedidos; no Mac, depois, 2,0%. A parte de testes falhando ficou perto de 41% nos dois. Mesmo modelo, mesmo nível de falha nos testes, quatro vezes menos interrupção. A minha leitura é que, com o Specsfy, boa parte dos pedidos virou resposta a pergunta numerada ou pedido de fase inteira, que não tem por que ser cortado no meio. Mas a máquina e a época mudaram juntas, e o Windows rodou quase tudo em xhigh, então o dado não separa uma coisa da outra.
Os dois pontos de baixo, ligados pela linha, são os modelos que vieram depois, de setembro em diante: o gpt-6.1-sol e o gpt-6-astra, com 23% e 27% de testes falhando. A linha liga os pontos que nenhum outro supera nas duas medidas ao mesmo tempo, mas o gpt-6.1-sol tem só 144 pedidos, e cada ponto ocupa um período próprio. O gráfico serve para ver o que aconteceu no meu uso. Para escolher modelo, precisaria das mesmas tarefas rodadas em cada um, e isso fica para outro texto. No Claude Code nem há o que comparar: o Opus 5.5 foi o modelo predominante em 394 das 415 sessões com spec.
Esforço de raciocínio
Os dois agentes deixam escolher quanto o modelo pensa antes de responder, de low a xhigh, e registram esse nível a cada turno. Não é o Effort de 1 a 10, que mede a dificuldade da spec. A pergunta aqui é se pensar mais compensa o custo. A única comparação limpa que eu tenho é uma célula do Codex em que só o nível mudou: o gpt-6-astra, no Mac, em setembro.
No gráfico, o eixo horizontal é o custo, em tokens por pedido, e o vertical, a parte das execuções de teste que falharam. Se pensar mais compensasse, os pontos da direita estariam mais embaixo.
Tokens por pedido, em mil (mediana)
Ver os números em tabela
| Braço | Execuções de teste que falharam (%) | Tokens por pedido, em mil (mediana) | Fronteira |
|---|---|---|---|
| medium (210 pedidos) | 16,9 | 438 | na fronteira |
| high (214 pedidos) | 36,5 | 935 | fora da fronteira |
| xhigh (251 pedidos) | 24,8 | 1232 | fora da fronteira |
Fonte: Transcripts locais do Codex: pedidos humanos do gpt-6-astra no Mac em setembro, pelo esforço vigente no turnocommit 17d0066MetodologiaBaixar JSONBaixar CSV
Nessa célula, high gastou o dobro de tokens por pedido de medium, e xhigh quase o triplo. O tempo por pedido subiu de 1 para 4 minutos, e o xhigh repetiu mais comando, 2,4 laços a cada 100 chamadas. Os testes que falharam não caíram com mais raciocínio: foram 17% em medium, 37% em high e 25% em xhigh, contando o RED, e o tipo de pedido também muda de um nível para outro. Pensar mais custou mais e não apareceu como menos erro. No Claude Code, quase tudo rodou em high, 205 das 218 specs concluídas, então lá não dá para separar o efeito do raciocínio.
Quanto custa
Somei os tokens de cada mensagem do Claude Code entre 21 de agosto e 7 de novembro e multipliquei pela tabela de preços da API. O uso é por assinatura, então o valor não é o que foi pago: serve para comparar as partes do trabalho. As sessões que acionaram alguma skill do Specsfy somaram cerca de US$ 25 mil equivalentes, e as que trabalharam numa spec sem acionar skill, mais US$ 6 mil. Juntas, ficaram com 93% do custo do período. A tabela divide o custo das sessões com skill pela fase em que cada mensagem aconteceu.
| Braço | Custo equivalente (US$ mil) | Parte do custo (%) |
|---|---|---|
| Antes da primeira skill da sessão | 2,6 | 10,4 |
| Documentação, especialistas e outras skills | 3,2 | 12,8 |
| Mudança tardia (reabrir uma spec definida) | 3,9 | 15,5 |
| Testes e implementação | 6,0 | 24,0 |
| Definir a spec: setup, inbox, backlog, criação, validação e tarefas | 9,3 | 37,3 |
Fonte: Transcripts locais do Claude Code, 290 arquivos de sessão com skill do Specsfy, preços públicos da APIcommit 17d0066MetodologiaBaixar JSONBaixar CSV
Definir a spec e mudá-la depois ficaram com cerca de 53% do custo das sessões com skill, e testes e implementação, com 24%. Definir é caro porque, para escrever a spec, o agente lê muito código, e essa leitura conta como definir. No total, a mudança tardia custou US$ 3,9 mil, perto dos US$ 4,7 mil de implementar, e essa conta inclui implementar a própria mudança. Por spec concluída no Claude Code, a mediana foi de US$ 51 equivalentes. O método gasta mais na conversa do que no código, e é por isso que reabrir uma spec pesa.
Quando vale
O custo de uma spec cresce com a dificuldade dela, mas o preço de cada critério de aceite muda pouco.
| Braço | Custo equivalente por spec (US$) | Specs com mudança tardia (%) | Minutos de trabalho do agente | Custo por critério de aceite (US$) |
|---|---|---|---|---|
| Effort 3-4 (58 specs) | 24 | 9 | 22 | 2,66 |
| Effort 5-6 (76 specs) | 51 | 20 | 114 | 2,73 |
| Effort 7-8 (67 specs) | 77 | 46 | 201 | 3,17 |
Fonte: Transcripts locais do Claude Code e spec.md atuais: 201 specs concluídas com Effort de 3 a 8commit 17d0066MetodologiaBaixar JSONBaixar CSV
De Effort 3-4 para 7-8, a spec mediana vai de US$ 24 para US$ 77 equivalentes, e o trabalho do agente, de 22 para 201 minutos. Nessas faixas, cada critério de aceite custa entre US$ 2,66 e US$ 3,17. O que cresce mais rápido é a mudança tardia: 9% das specs de Effort 3-4 foram reabertas, contra 46% das de Effort 7-8.
Uma dúvida que eu tinha era se spec com tela, com interface para pessoas, custa mais só por ser maior. Para separar as duas coisas, comparei com e sem tela dentro da mesma faixa de Effort. No gráfico, cada ponto é uma faixa com ou sem tela: o eixo horizontal é o custo mediano por spec, e o vertical, a parte das specs reabertas. O canto de baixo, à esquerda, é o mais barato e o que menos volta.
Custo equivalente por spec, mediana (US$)
Ver os números em tabela
| Braço | Specs com mudança tardia (%) | Custo equivalente por spec, mediana (US$) | Fronteira |
|---|---|---|---|
| Effort 3-4, com tela (11 specs) | 0 | 22 | na fronteira |
| Effort 3-4, sem tela (44 specs) | 11 | 23 | fora da fronteira |
| Effort 5-6, com tela (37 specs) | 30 | 58 | fora da fronteira |
| Effort 5-6, sem tela (38 specs) | 16 | 36 | fora da fronteira |
| Effort 7-8, com tela (51 specs) | 55 | 68 | fora da fronteira |
| Effort 7-8, sem tela (24 specs) | 50 | 66 | fora da fronteira |
Fonte: Transcripts locais do Claude Code e spec.md atuais: specs concluídas de Effort 3-8, mediana do custo equivalente por speccommit 17d0066MetodologiaBaixar JSONBaixar CSV
A tela pesa no meio da escala. Em Effort 5-6, as specs com tela custaram US$ 58 na mediana, contra US$ 36 sem tela, e foram reabertas quase duas vezes mais, 30% contra 16%. Nas specs pequenas e nas grandes, os pontos com e sem tela quase se encostam: o custo é praticamente o mesmo, e o que manda é a faixa. A minha leitura é que, numa spec média, a tela ainda está sendo descoberta enquanto o agente implementa, e cada descoberta vira mudança tardia; nas grandes, a mudança tardia já é alta de qualquer jeito.
O que eu tiro disso:
- Dividir antes de começar. Em Effort 7-8, quase metade das specs voltou depois de definida.
- Conversar mais sobre a tela nas specs médias. É ali que a interface mais encarece e mais reabre.
- Deixar o ajuste pequeno fora. Nos nove repositórios, 187 sessões não trabalharam em spec nenhuma, com mediana de US$ 2,94 cada. As specs de Effort 1-2 são poucas, só 8, para dizer quanto custa o piso.
- Manter o portão. Na auditoria de outubro, o agente tinha pulado o RED e dito que terminou. Como tarefa, critério e teste estão no mesmo arquivo, a revisão achou.
O pronto que ficou para trás
Quando conferi as specs que passaram só pelo Codex, muitas pareciam abertas, e eu desconfiei que estavam prontas e só não tinham sido fechadas. Uma spec só sai da lista de abertas quando vai para specs/completed/, e esse passo depende de alguém pedir. Então olhei todas as specs fora dessa pasta nos nove repositórios e separei pela situação real de cada uma.
| Braço | Specs | Paradas há mais de 30 dias |
|---|---|---|
| Marcadas como concluídas, mas não movidas | 37 | 8 |
| Faltam uma ou duas tarefas | 36 | 7 |
| Trabalho de fato em aberto | 20 | 5 |
| Todas as tarefas feitas, portão de entrega aberto | 10 | 3 |
Fonte: Ramo principal remoto dos nove repositórios: 103 specs fora de specs/completed/commit 17d0066MetodologiaBaixar JSONBaixar CSV
No fim de 7 de novembro, eram 103. Destas, 37 já estavam marcadas como concluídas e 10 tinham todas as tarefas feitas com o portão de entrega aberto: 47 specs prontas, ou quase, fora do lugar. Em 36 faltavam uma ou duas tarefas, e só 20 tinham trabalho de fato pela frente. As 18 paradas há mais de um mês, sem contar as que têm trabalho em aberto, são todas do Fuad Next, do fim de agosto ao começo de outubro. O portão diz o que é pronto, mas mover a spec é um passo à parte, e ele fica esquecido quando a atenção já foi para a próxima. Esse fechamento precisa virar rotina, do mesmo jeito que o PR virou.
O que continuou por nossa conta
- A passagem entre sessões. O Specsfy não trata a continuidade de uma sessão para outra, nem de uma máquina para outra, e o handoff continuou.
- A disciplina de entrega. Um PR por spec numa worktree própria, o aceite do próprio agente no app real e a revisão do Codex antes do merge são regras nossas.
- Remendos no instrumento. A rastreabilidade ganhou um invólucro, porque um mesmo marcador de teste muitas vezes valia para mais de uma spec. O contrato do framework ganhou um único patch, protegido por teste: permitir tipos e assinaturas inertes antes do RED, sem afrouxar o TDD.
Metodologia
Os dados foram medidos em 7 de novembro de 2026, sem rodar nenhum modelo novo. Os pedidos são de uma pessoa só.
- Specs, critérios, tarefas e marcadores vêm dos arquivos
spec.mde dos testes versionados nos nove repositórios, contados por script. Critérios contam IDs únicos por spec. Inbox, backlog e milestones são os arquivos despecs/inbox/,specs/backlog/especs/milestones/. A auditoria de abertura vem das decisões registradas no Fuad Next naquele dia. - No Claude Code, entram os transcripts locais de 21 de agosto a 7 de novembro: 680 arquivos de sessão, em três grupos. São 290 que acionaram alguma skill do Specsfy, 158 que editaram arquivos de spec sem acionar skill e 232 sem relação com spec, 45 delas fora dos nove repositórios. Os pedidos humanos são 6.203, sem duplicatas, notificações, mensagens automáticas, resumos de compactação e o briefing que uma sessão coordenadora manda para outra. A fase de um pedido ou de uma mensagem é a última skill acionada antes dela, e a sessão conta para a spec que ela mais editou.
- Os 117 pedidos encadeados, os pedidos por entrega e a divisão do custo por fase vêm de uma primeira contagem, feita antes de tirar as duplicatas de sessões retomadas; por isso o custo por fase soma US$ 25,0 mil, contra US$ 25,2 mil na contagem nova. Os pedidos de antes de agosto vêm do histórico de texto digitado, que sobreviveu à limpeza dos transcripts.
- No Codex, entram as 366 sessões interativas com pedido humano, de abril a 7 de novembro, no Mac, no notebook Windows e no WSL. Ficam fora as de subagente, de voz, de automação e as chamadas por outro agente. Laço é o mesmo comando repetido três vezes em dez chamadas, sem contar esperas. Testes que falharam incluem o RED esperado do TDD, e até 19 de agosto 72% das execuções de teste do Codex não registravam o código de saída, então a falha vem do texto.
- O custo usa a tabela de preços da API na versão de 6 de outubro de 2026, com escrita de cache a 1,25 vez o input (5 minutos) e 2 vezes (1 hora). Ler código para escrever a spec conta como definir. O custo por spec ignora o trabalho feito no Codex nessas specs, e Effort e interface são os do
spec.mdatual. - Claude Code contra Codex compara, de 21 de agosto a 7 de novembro, as sessões do Claude Code que acionaram skill do Specsfy com as sessões interativas do Codex que leram uma skill do Specsfy, só no fio principal. Laço usa a mesma regra nos dois. O esforço de raciocínio vem do campo
effortde cada turno nos dois agentes, e cada pedido fica com o nível mais frequente na sua janela. - As specs fora de
completed/foram lidas no ramo principal remoto de cada repositório no fim de 7 de novembro, quando já eram 569 specs. “Marcada como concluída” é o Status Complete ou o Delivery Gate aprovado, e “parada” é a spec cuja pasta não recebe commit há mais de 30 dias. - No gráfico de modelos do Codex, cada ponto é uma combinação de modelo predominante da sessão, máquina e época, antes ou depois de 20 de agosto, com 100 pedidos ou mais; ficaram fora 13 combinações menores, com 122 pedidos. Pedido interrompido é o que eu cortei antes de o agente terminar. Os dois agentes contam tokens de forma diferente, então os tokens comparam só a ordem de grandeza.
- Autonomia é o tempo entre um pedido meu e a última ação do agente antes do pedido seguinte. Os transcripts do Claude Code anteriores a agosto não existem mais, e por isso não há comparação de custo entre antes e depois.
- O antes e depois do Fuad Next usa o git e o GitHub de 29 de maio a 19 de agosto e de 20 de agosto a 7 de novembro. O repositório no GitHub existe desde 1º de junho, e o CI do antes quase não existia. Um achado da revisão do Codex é uma revisão dele com comentário antes do merge. Retrabalho é um commit de correção que chega à
mainem até 7 dias e toca um arquivo de produção criado pelo PR. - Pedidos por entrega somam o Claude Code e o Codex no Fuad Next, sem comandos de barra. Specs ainda abertas ficam fora do denominador, o que favorece o antes.
Limites que importam: é uma pessoa só, em projetos da mesma casa, num período em que modelo, agente, máquina e método mudaram juntos. Os números descrevem o fluxo. Não provam que o Specsfy, sozinho, melhora ou piora alguma coisa.
Rascunho de agente a partir das fontes listadas; revisado e aprovado por Lucas Fuad